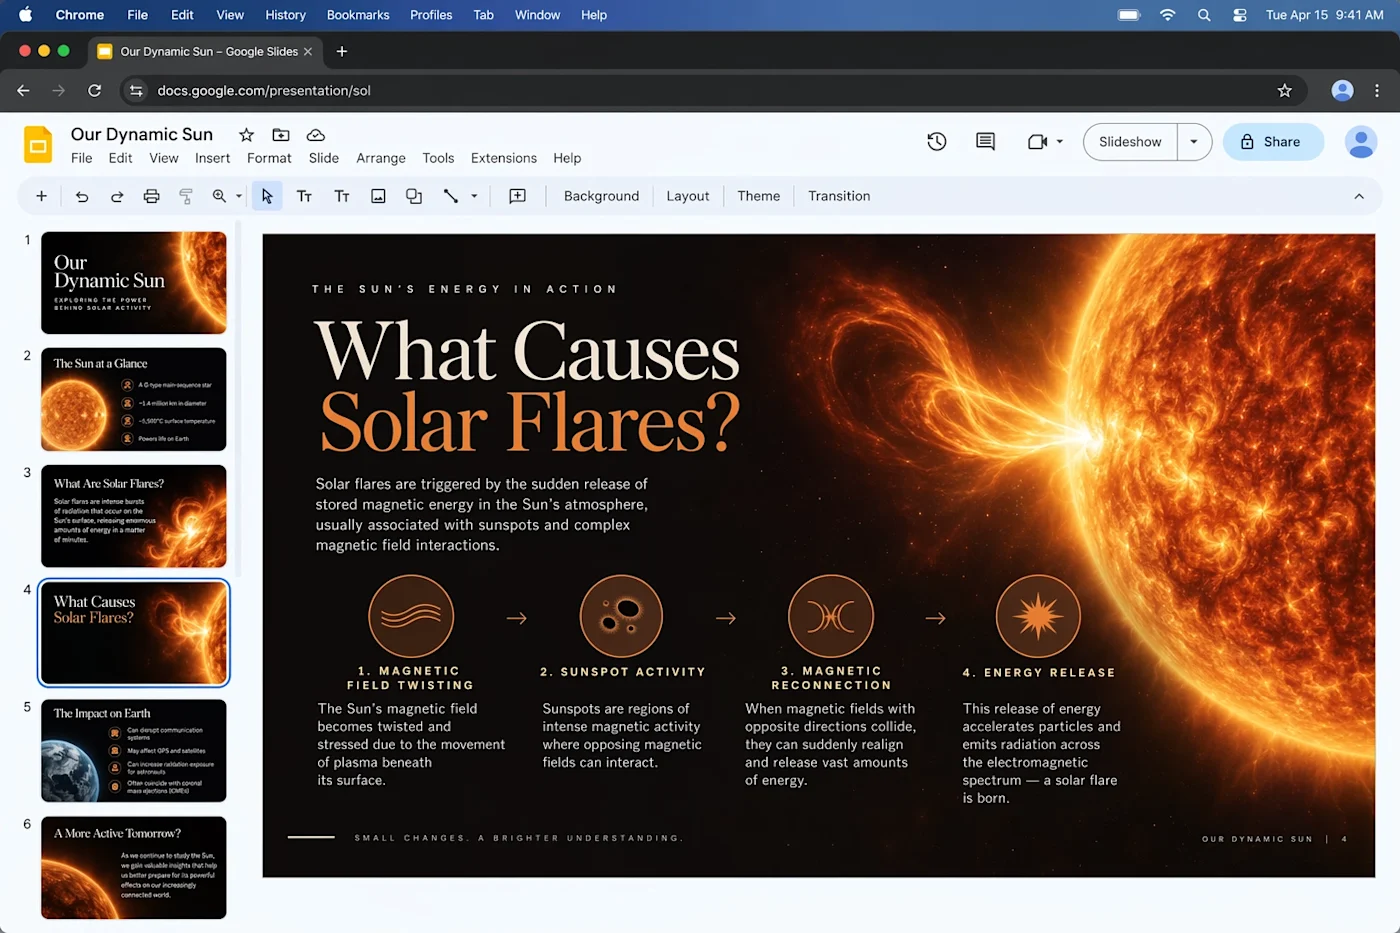
本文依据当前官方模型文档整理,并把产品信息转成中文用户可以直接执行的选择与创作方法。
适合 Python 的两类场景
Python 很适合后端生成服务,也适合离线批量制作素材。前者重视用户隔离、队列和超时,后者重视任务清单、断点续跑和结果命名,两者不应共用一个无状态循环。
环境和密钥管理
使用项目虚拟环境与当前官方 SDK,把 API Key 放在进程环境或密钥管理服务。示例脚本不要打印完整请求头,异常日志也要过滤密钥、用户文件路径和私人提示词。
生成任务的数据结构
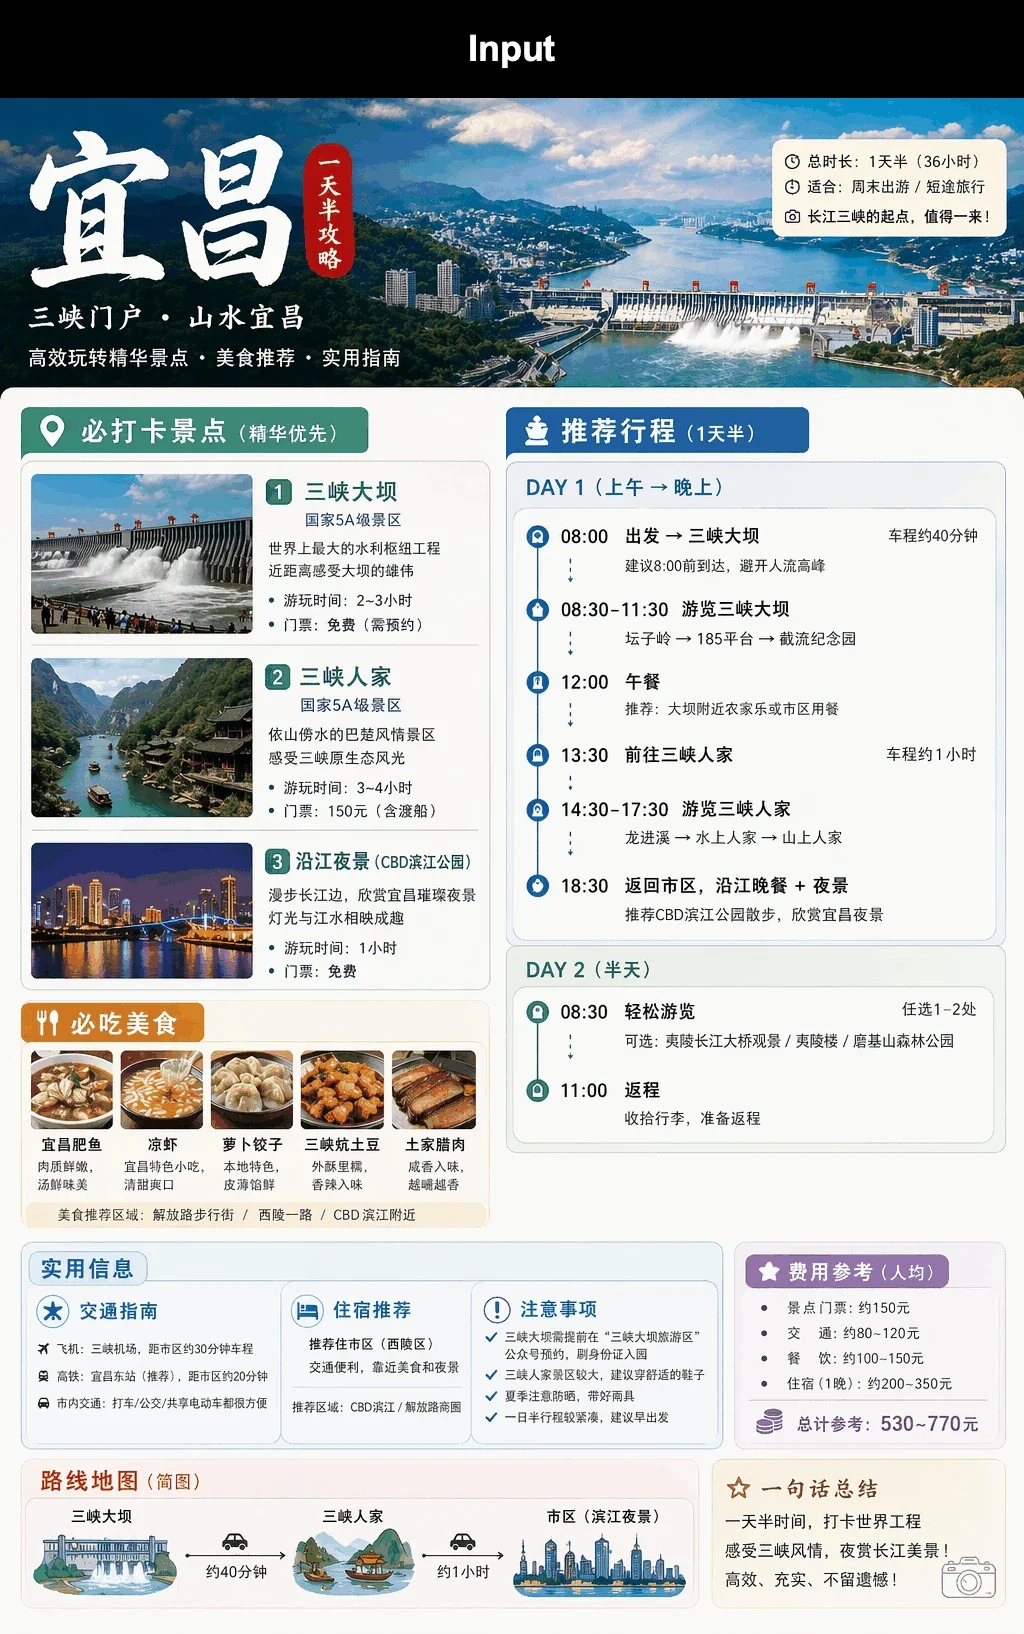
用明确字段保存 prompt、model、quality、input_images、output_name 和 business_id。把一条长字符串拆成任务对象,后续才能按模型、场景和失败原因统计。
最终用途 + 必须保留的主体 + 场景与构图 + 材质和光线 + 文字要求 + 禁止改变的内容。
编辑任务怎样传参考图
读取前先检查格式、体积和像素,确认图片属于当前用户。多张参考图要标明各自用途,例如第一张锁定人物、第二张提供服装、第三张只参考环境。
批量生成要能恢复
为每个任务生成稳定 ID,成功后写入清单,重新运行时跳过已完成项。限制并发并对限流做退避;内容拒绝和参数错误不应无条件重复请求。
- 主体、Logo 和文字是否准确
- 边缘、材质和光线是否自然
- 比例和清晰度是否适合发布渠道
- 素材与结果是否具备使用权限
结果验收与自动化边界
脚本可以检查文件是否存在、尺寸、透明通道和基本元数据,但无法代替对文字、人物、产品结构和权利风险的人工判断。正式发布前仍要进入审核队列。
关于GPT Image 2.5 Python API 教程的常见问题
GPT Image 2.5 Python API 教程应该从哪里开始?
Python 很适合后端生成服务,也适合离线批量制作素材。前者重视用户隔离、队列和超时,后者重视任务清单、断点续跑和结果命名,两者不应共用一个无状态循环。
使用GPT Image 2.5 Python API 教程时,怎样减少返工?
先把任务拆成可以单独验收的步骤,并在每轮只改变少量变量。用明确字段保存 prompt、model、quality、input_images、output_name 和 business_id。把一条长字符串拆成任务对象,后续才能按模型、场景和失败原因统计。
GPT Image 2.5 Python API 教程的结果可以直接发布吗?
不建议跳过人工验收。脚本可以检查文件是否存在、尺寸、透明通道和基本元数据,但无法代替对文字、人物、产品结构和权利风险的人工判断。正式发布前仍要进入审核队列。